
Fine-Tuning de LLaMA 3.1 con QLoRA en una GPU de Consumo: Guía Paso a Paso con Hugging Face TRL y PEFT
Durante los primeros años del auge de los modelos fundacionales, el ajuste fino (fine-tuning) de un modelo de lenguaje con miles de millones de parámetros era un privilegio restringido a grandes corporaciones y laboratorios de investigación dotados de presupuestos millonarios en computación en la nube. Entrenar todos los pesos de un modelo de 8.000 millones de parámetros en precisión float32 o bfloat16 requería clústeres de servidores equipados con múltiples tarjetas NVIDIA A100 u H100 de 80GB de VRAM interconectadas por NVLink, dejando fuera del juego a pequeñas empresas, investigadores independientes y desarrolladores individuales.
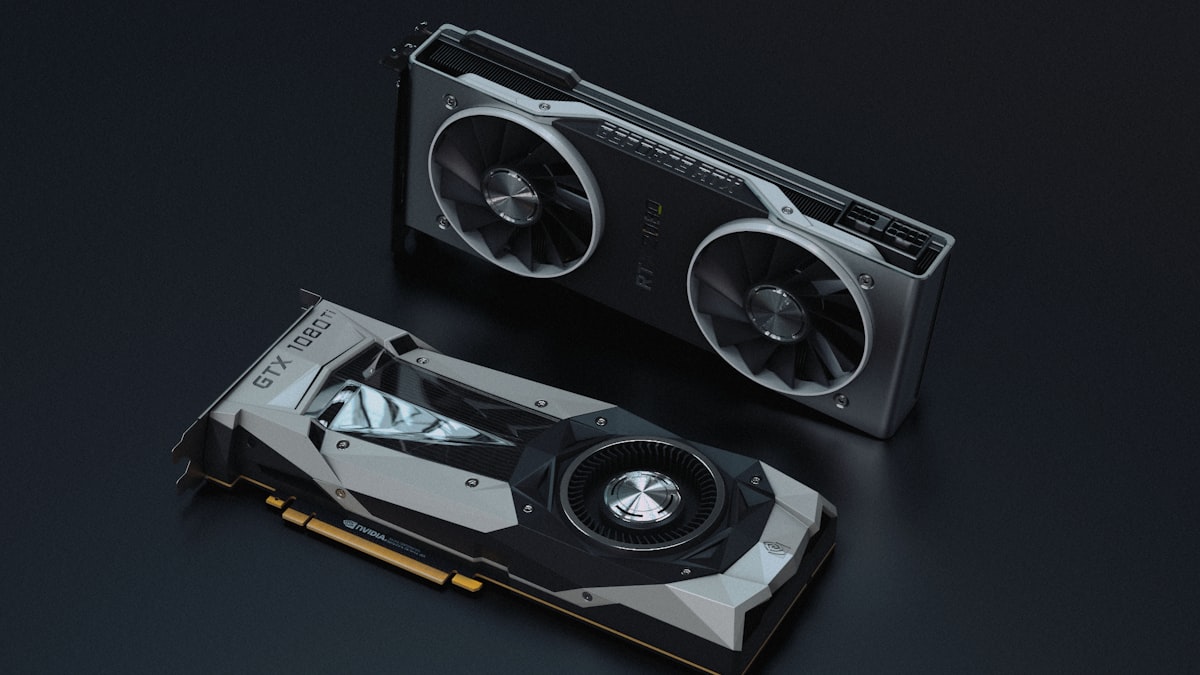
Esta barrera insalvable cayó con el desarrollo y estandarización del método QLoRA (Quantized Low-Rank Adaptation), concebido por Tim Dettmers y la Universidad de Washington. Al combinar la cuantización del modelo base a 4 bits utilizando el tipo de dato NormalFloat4 (NF4) con la inyección de matrices de bajo rango entrenables (LoRA), QLoRA permite realizar un ajuste fino de calidad profesional sobre modelos punteros como LLaMA 3.1 8B utilizando una única tarjeta gráfica de consumo, como una NVIDIA GeForce RTX 3090, RTX 4090 o incluso una GPU de 16GB de VRAM.
De acuerdo con publicaciones académicas en NeurIPS Conference Proceedings y el repositorio de referencia en Hugging Face PEFT en GitHub, el fine-tuning con QLoRA retiene más del 99.3% del rendimiento del ajuste fino completo (Full Fine-Tuning), reduciendo el consumo de memoria gráfica en más de un 65%. Como hemos detallado al analizar generación de datos sintéticos con LLMs y las técnicas de Constitutional AI y RLHF, adaptar los pesos del modelo a tu dominio es el paso definitivo para alcanzar la excelencia técnica.
🧪 Manual de Fine-Tuning con QLoRA para LLaMA 3.1 8B
- 👉 1. Fundamentos Matemáticos: Cómo QLoRA Reduce el Consumo de VRAM sin Perder Precisión
- 👉 2. Requisitos de Hardware y Configuración de Librerías (BitsAndBytes, PEFT, TRL)
- 👉 3. Curaduría y Formateo del Dataset de Instrucciones con Plantilla LLaMA 3.1
- 👉 4. Carga en 4-Bits con BitsAndBytes y Definición de Hiperparámetros LoRA (r, alpha)
- 👉 5. Bucle de Entrenamiento con SFTTrainer: Learning Rate, Warmup y Gradient Checkpointing
- 👉 6. Tabla Comparativa: Full Fine-Tuning vs. LoRA vs. QLoRA en LLaMA 3.1
- 👉 7. Fusión de Adaptadores (Merge) y Conversión a Formato GGUF para Ollama / vLLM
- 👉 8. Preguntas Frecuentes sobre Fine-Tuning con QLoRA en GPUs de Consumo
1. Fundamentos Matemáticos: Cómo QLoRA Reduce el Consumo de VRAM sin Perder Precisión
Para comprender la genialidad técnica de QLoRA, es necesario descomponer sus tres innovaciones matemáticas fundamentales:
Tipo de Dato NormalFloat4 (NF4): Los pesos de las redes neuronales preentrenadas siguen de forma casi universal una distribución normal gaussiana centrada en cero. A diferencia de la cuantización lineal entera estándar (INT4), que divide el rango de valores en intervalos equidistantes desperdiciando precisión en los extremos, NF4 asigna un número igual de valores a cada contenedor estadístico de la distribución normal, optimizando la capacidad informativa teórica de los 4 bits.
Doble Cuantización (Double Quantization): Cuantiza no solo los pesos del modelo, sino también las constantes de escalado (los factores que permiten des-cuantizar los bloques de 4 bits durante el paso hacia adelante). Esto ahorra aproximadamente 0.37 bits por parámetro, lo que en un modelo de 8B supone liberar casi 3 gigabytes adicionales de VRAM.
Paginación de Gradientes (Paged Optimizers): Aprovecha la memoria unificada de CUDA para transferir temporalmente los estados del optimizador AdamW desde la VRAM de la GPU hacia la memoria RAM del sistema cuando se producen picos de longitud de secuencia, evitando los temidos errores de CUDA Out of Memory (OOM).

Las GPUs de consumo con 16GB o 24GB de VRAM pueden ajustar modelos de 8B parámetros gracias a la cuantización NF4.
2. Requisitos de Hardware y Configuración de Librerías (BitsAndBytes, PEFT, TRL)
El entorno técnico ideal para realizar este tutorial comprende:
- GPU: NVIDIA RTX 3090 / 4090 (24GB VRAM) o RTX 4070 Ti / 4080 (16GB VRAM con longitud de secuencia limitada a 2048 tokens).
- Sistema Operativo: Linux (Ubuntu 22.04 / 24.04 LTS) o Windows 11 con WSL2 configurado.
- CUDA Toolkit: Versión 12.1 o 12.4 con controladores NVIDIA actualizados.
Instalamos la suite de software especializada de Hugging Face y PyTorch:
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu121
pip install transformers accelerate bitsandbytes peft trl datasets
Verificamos que bitsandbytes detecte correctamente la GPU ejecutando en la consola de comandos de Python: python -c "import bitsandbytes as bnb; print(bnb.__file__)".
3. Curaduría y Formateo del Dataset de Instrucciones con Plantilla LLaMA 3.1
LLaMA 3.1 utiliza una plantilla de chat específica gobernada por tokens especiales de control (<|start_header_id|>, <|end_header_id|>, <|eot_id|>). Si formateamos los datos incorrectamente, el modelo degradará su capacidad de conversación.
Estructuramos nuestro dataset en formato JSONL con la lista de mensajes estándar de Hugging Face:
[
  {
    "messages": [
      {"role": "system", "content": "Eres un asistente médico experto en farmacología clínica."},
      {"role": "user", "content": "¿Cuáles son las contraindicaciones principales de la metformina?"},
      {"role": "assistant", "content": "La metformina está contraindicada en pacientes con insuficiencia renal grave (TFG < 30 ml/min), acidosis metabólica aguda..."}
    ]
  }
]
La librería TRL aplica automáticamente la plantilla del tokenizador mediante el argumento formatting_func o utilizando directamente la función apply_chat_template.

El formateo estricto del dataset con los tokens de control de LLaMA 3.1 asegura una generalización conversacional óptima.
4. Carga en 4-Bits con BitsAndBytes y Definición de Hiperparámetros LoRA (r, alpha)
Configuramos la cuantización NF4 y definimos qué matrices de atención recibirán los adaptadores de bajo rango:
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
from peft import LoraConfig, prepare_model_for_kbit_training

model_id = "meta-llama/Meta-Llama-3.1-8B-Instruct"

# 1. Cuantización de 4 bits NF4
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
    bnb_4bit_use_double_quant=True
)

# 2. Cargar modelo base
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    quantization_config=bnb_config,
    device_map="auto"
)
model = prepare_model_for_kbit_training(model)

# 3. Configuración de adaptadores LoRA
peft_config = LoraConfig(
    r=16,                         # Rango de la matriz (Rank)
    lora_alpha=32,                # Factor de escalado
    target_modules=[              # Aplicar a todas las capas de atención y MLP
        "q_proj", "k_proj", "v_proj", "o_proj",
        "gate_proj", "up_proj", "down_proj"
    ],
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM"
)
Con esta configuración, de los 8.000 millones de parámetros del modelo original, solo entrenaremos aproximadamente 40 millones de parámetros (menos del 0.5% del total), lo que reduce drásticamente las necesidades computacionales.
5. Bucle de Entrenamiento con SFTTrainer: Learning Rate, Warmup y Gradient Checkpointing
Utilizamos el SFTTrainer (Supervised Fine-Tuning Trainer) de la librería TRL para orquestar la optimización con gradient checkpointing activado para no saturar la memoria:
from trl import SFTTrainer
from transformers import TrainingArguments

training_args = TrainingArguments(
    output_dir="./llama3-1-custom-qlora",
    per_device_train_batch_size=2,
    gradient_accumulation_steps=8,  # Batch efectivo = 16
    warmup_ratio=0.03,
    max_steps=500,
    learning_rate=2e-4,
    fp16=False,
    bf16=True,                      # Indispensable en Ampere/Ada Lovelace
    logging_steps=10,
    optim="paged_adamw_8bit",       # Optimizador paginado que ahorra VRAM
    gradient_checkpointing=True,
    save_strategy="steps",
    save_steps=100
)

trainer = SFTTrainer(
    model=model,
    train_dataset=dataset,
    peft_config=peft_config,
    max_seq_length=2048,
    tokenizer=tokenizer,
    args=training_args
)

trainer.train()
trainer.model.save_pretrained("./final_adapter")
El proceso tarda habitualmente entre 45 minutos y 2 horas para un dataset de 2.000 ejemplos en una RTX 4090, con un consumo estable de memoria de unos 14GB de VRAM.

El optimizador paged_adamw_8bit permite gestionar los gradientes con holgura dentro de los límites de una GPU doméstica.
6. Tabla Comparativa: Full Fine-Tuning vs. LoRA vs. QLoRA en LLaMA 3.1
Analizamos las exigencias computacionales y el rendimiento relativo de las principales metodologías de ajuste fino:
7. Fusión de Adaptadores (Merge) y Conversión a Formato GGUF para Ollama / vLLM
Tras finalizar el entrenamiento, disponemos de una pequeña carpeta con los adaptadores LoRA (unos 150 MB). Para poner el modelo en producción de alta velocidad, fusionamos los pesos LoRA con el modelo original de 16 bits:
from peft import PeftModel

base_model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.bfloat16,
    device_map="auto"
)

# Cargar y fusionar pesos LoRA en el modelo base
merged_model = PeftModel.from_pretrained(base_model, "./final_adapter")
merged_model = merged_model.merge_and_unload()
merged_model.save_pretrained("./llama3-1-finetuned-merged")
tokenizer.save_pretrained("./llama3-1-finetuned-merged")
Con el modelo fusionado, podemos utilizar el script convert_hf_to_gguf.py de llama.cpp para exportarlo a formato GGUF cuantizado a Q4_K_M o Q8_0, permitiendo ejecutarlo en Ollama con un simple ollama create mi-modelo -f Modelfile y servirlo en cualquier servidor local o edge computing con latencias ultra-bajas.
Estrategias de Evaluación y Validación Post-Entrenamiento: Para certificar que el fine-tuning ha mejorado efectivamente las destrezas deseadas sin degradar la coherencia sintáctica, es imprescindible someter al modelo fusionado a una batería de pruebas automatizadas. Utilizando frameworks como LM-Evaluation-Harness o benchmarks específicos de dominio (como MMLU en español o HumanEval para generación de código), comparamos las respuestas del modelo base frente al modelo ajustado. Esta auditoría cuantitativa previene el despliegue de pesos con sobreajuste y garantiza que el comportamiento en producción responda con rigurosa exactitud a las directrices corporativas fijadas.
8. Preguntas Frecuentes sobre Fine-Tuning con QLoRA en GPUs de Consumo
¿Cuántos ejemplos de entrenamiento necesito como mínimo para un fine-tuning efectivo?
Para adaptar el modelo a un tono de voz específico, estilo de respuesta o formato de salida JSON estructurado, entre 500 y 2.000 ejemplos de alta calidad técnica son suficientes. En fine-tuning supervisado (SFT), la calidad, diversidad y coherencia de los ejemplos es infinitamente más crítica que la cantidad bruta; 1.000 ejemplos curados minuciosamente superan a 50.000 ejemplos con ruido o inconsistencias.
¿Puede QLoRA enseñar nuevos conocimientos fácticos al modelo que no vio en preentrenamiento?
No es el enfoque idóneo. El fine-tuning es excelente para enseñar forma, estilo, razonamiento procedimental y sintaxis de dominio, pero es ineficiente y propenso a alucinaciones para memorizar hechos enciclopédicos nuevos. Para inyectar información dinámica, catálogo de productos o normativas cambiantes, la arquitectura recomendada es RAG (Retrieval-Augmented Generation), pudiendo combinarse un modelo fine-tuneado con un sistema RAG para obtener lo mejor de ambos mundos.
¿Qué diferencia hay entre los hiperparámetros 'r' y 'lora_alpha'?
El hiperparámetro 'r' (rank) define la dimensión intrínseca de las matrices de bajo rango; valores comunes son 8, 16, 32 o 64 (a mayor rank, mayor capacidad expresiva pero mayor consumo de memoria). Por su parte, 'lora_alpha' es un factor de escala matemática que pondera el peso relativo de las actualizaciones LoRA frente a los pesos congelados originales. Como regla práctica general en la comunidad, se suele fijar 'lora_alpha' como el doble del valor de 'r' (por ejemplo, r=16, alpha=32).
¿Qué es el 'olvido catastrófico' (Catastrophic Forgetting) y cómo se previene?
El olvido catastrófico ocurre cuando un modelo ajustado pierde sus habilidades generales previas (como razonar en matemáticas o mantener una conversación cotidiana fluida) al sobreespecializarse en el dataset de destino. Para mitigarlo, se recomienda mantener tasas de aprendizaje conservadoras (1e-4 a 2e-4), aplicar dropout moderado en LoRA (0.05 a 0.1) e incorporar un 10% de ejemplos de conversación general (replay dataset) dentro de los datos de entrenamiento.