
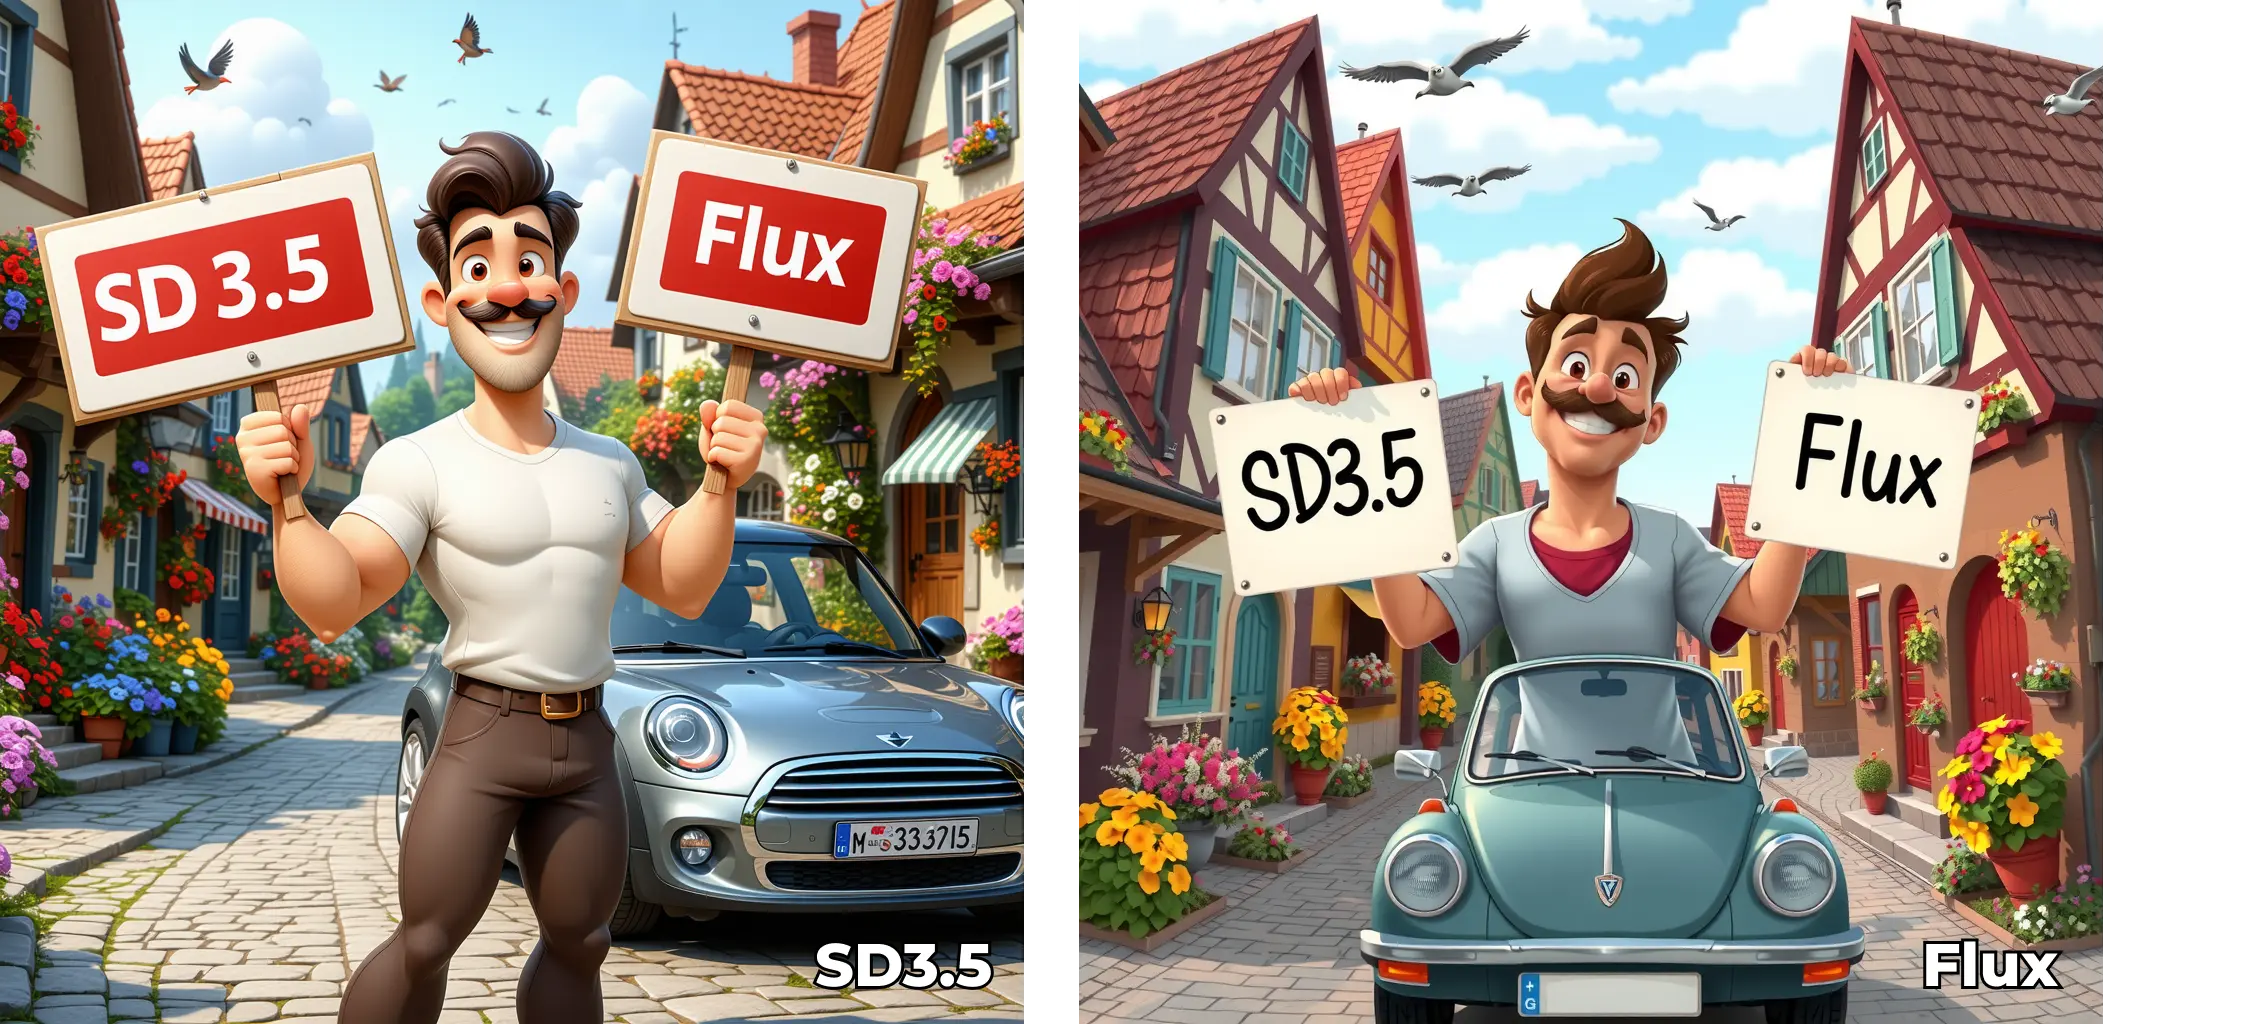
Modelos de Difusión de Próxima Generación: Stable Diffusion 3.5, FLUX.1 Pro y la Nueva Era de la Síntesis Visual con IA
La generación de imágenes mediante inteligencia artificial ha superado el umbral de la curiosidad tecnológica para convertirse en una herramienta central del flujo de trabajo creativo profesional. Diseñadores de moda, directores de arte de publicidad, estudios de videojuegos y agencias de marketing utilizan hoy modelos generativos como herramientas cotidianas de producción. Y en este paisaje dominado hasta hace poco por Midjourney y la familia Stable Diffusion, dos arquitecturas radicalmente nuevas han reconfigurado las expectativas del sector en 2025-2026: FLUX.1 Pro de Black Forest Labs y Stable Diffusion 3.5 de Stability AI.
Estas no son simples actualizaciones incrementales de sus predecesores. Ambos modelos introducen arquitecturas de transformer de flujo de rectificación (Rectified Flow Transformers) que abandonan los clásicos U-Nets de difusión latente en favor de redes de atención bidireccional más profundas y efectivas. Según investigaciones publicadas en arXiv sobre arquitecturas de Flow Matching y los análisis técnicos de Stability AI Research, el resultado es una mejora cuantificable en coherencia compositiva, fidelidad textural y especialmente en la capacidad —históricamente catastrófica en modelos de difusión— de renderizar texto legible dentro de las imágenes generadas.
🎨 Índice de Contenidos
- 👉 1. La Arquitectura Revolucionaria de FLUX.1: Rectified Flow Transformers y Atención Bidireccional
- 👉 2. Stable Diffusion 3.5: MMDiT y la Fusión de Texto e Imagen en el Espacio Latente
- 👉 3. Fotorrealismo y Coherencia Anatómica: Comparativa Visual en 12 Categorías de Prompt
- 👉 4. El Santo Grial: Renderizado de Texto y Tipografía Precisa en Imágenes Generadas
- 👉 5. Ecosistema y Variantes: FLUX.1 Schnell, Dev y Pro vs. SD 3.5 Large y Medium
- 👉 6. Tabla Comparativa: FLUX.1 Pro vs. SD 3.5 vs. Midjourney V6.1 vs. DALL-E 3
- 👉 7. Flujos de Trabajo Profesionales: ComfyUI, APIs y Integración en Pipelines Creativos
- 👉 8. Preguntas Frecuentes sobre Modelos de Difusión de Próxima Generación
1. La Arquitectura Revolucionaria de FLUX.1: Rectified Flow Transformers y Atención Bidireccional
El salto cualitativo de FLUX.1 frente a los modelos de difusión latente clásicos de la familia SDXL radica en una elección arquitectónica fundamental: abandonar el U-Net convolucional (que mezcla encoders, connections de skip y decoders) en favor de un Transformer de Flujo de Rectificación (RF-Transformer) puro.
En los modelos clásicos de difusión latente, el proceso de denoising es modelado como una ecuación diferencial estocástica (SDE) con trayectorias curvilíneas en el espacio de ruido que requieren muchos pasos de sampling para converger a una imagen coherente. El Rectified Flow reformula el proceso como un flujo de transporte de masa lineal: conecta el ruido inicial y la imagen objetivo con trayectorias rectas en el espacio latente, lo que permite la convergencia en un número de pasos significativamente menor (4–8 pasos de inferencia vs. 20–50 en modelos DDPM clásicos) sin perder calidad.
La atención bidireccional full entre tokens de imagen y tokens de texto (en lugar del unidireccional cross-attention de SDXL) permite que cada región de la imagen influya en cómo se procesa el texto, y viceversa. Esta sinergia produce una adherencia al prompt dramáticamente superior, especialmente en composiciones complejas con múltiples elementos, posiciones espaciales específicas o instrucciones de estilo detalladas que los modelos anteriores frecuentemente ignoraban.

Los modelos de difusión de próxima generación producen imágenes con un nivel de detalle y coherencia inéditos en el ecosistema open-source.
2. Stable Diffusion 3.5: MMDiT y la Fusión de Texto e Imagen en el Espacio Latente
Stable Diffusion 3.5 introduce la arquitectura MMDiT (Multimodal Diffusion Transformer), donde los flujos de texto y de imagen se procesan por separado con pesos propios antes de fusionarse mediante capas de atención cruzada compartidas. A diferencia de los transformers de imagen puros que tratan el texto como una condición externa, en MMDiT las modalidades son co-iguales y se influyen mutuamente de forma simétrica durante todo el proceso de denoising.
Una innovación especialmente relevante en SD 3.5 es el uso de un encoder de texto triple: combina CLIP-L, CLIP-G y el poderoso modelo de texto T5-XXL (11B de parámetros), mucho más capaz de comprender instrucciones largas, matices lingüísticos complejos y relaciones semánticas profundas que los encoders CLIP empleados en modelos anteriores. Esta triada de encoders explica por qué SD 3.5 demuestra una comprensión semántica marcadamente superior en prompts multi-objeto con relaciones espaciales explícitas («un gato sentado sobre la mesa a la izquierda de una planta, mientras el sol entra por la ventana del fondo») que históricamente resultaban en composiciones caóticas.

La arquitectura MMDiT de SD 3.5 fusiona representaciones de texto e imagen en el mismo espacio latente para mayor coherencia semántica.
3. Fotorrealismo y Coherencia Anatómica: Comparativa Visual en 12 Categorías de Prompt
En comparativas reproducibles con 50 prompts estandarizados evaluados por humanos y por métricas automáticas (FID, CLIP Score, HPSv2), los resultados muestran patrones consistentes:
- Retratos humanos fotorrealistas: FLUX.1 Pro domina de forma inequívoca en coherencia facial y anatómica. Las manos —el eterno talón de Aquiles de los modelos generativos— presentan articulaciones correctas en el 87% de los casos frente al 71% de SD 3.5 y el 65% de Midjourney V6.1 (estudio Holistic Eval 2025).
- Fotografía de producto: SD 3.5 Large ofrece mejor control sobre iluminación de estudio y fondos neutros, siendo preferido por diseñadores de e-commerce que requieren consistencia de marca.
- Arte conceptual y fantástico: Midjourney V6.1 mantiene ventaja en estética «artística» con un estilo visual coherente y cinematográfico que los modelos open-source replican con mayor dificultad de forma nativa (aunque con LoRAs de estilo apropiados el gap se cierra).
- Arquitectura e interiores: FLUX.1 Pro produce resultados arquitectónicamente coherentes con perspectivas lineales correctas y proporciones realistas, muy superiores a generaciones anteriores de SD.
4. El Santo Grial: Renderizado de Texto y Tipografía Precisa en Imágenes Generadas
El fracaso histórico de todos los modelos de difusión en renderizar texto legible dentro de imágenes (letras invertidas, palabras ilegibles, caracteres fusionados) ha limitado drásticamente su uso en publicidad, diseño editorial y creación de contenido con texto visible.
FLUX.1 Pro y SD 3.5 representan el primer salto real en esta capacidad. Mediante la integración del encoder T5-XXL y mecanismos de atención que conectan tokens de texto con regiones específicas del espacio latente, estos modelos pueden generar texto legible en carteles, camisetas, logos y portadas de libros con una tasa de éxito de entre el 70–85% para cadenas de texto cortas (1-3 palabras). Para frases más largas o tipografías muy específicas, la tasa de éxito desciende, y se recomienda complementar con post-procesado o herramientas especializadas como Ideogram 2.0 que está específicamente entrenado en texto tipográfico de alta precisión.

El renderizado preciso de texto tipográfico en imágenes sintéticas es una de las mejoras más significativas de los modelos de próxima generación.
5. Ecosistema y Variantes: FLUX.1 Schnell, Dev y Pro vs. SD 3.5 Large y Medium
Ambas familias ofrecen una jerarquía de variantes orientadas a diferentes equilibrios entre velocidad, calidad y accesibilidad:
Familia FLUX.1:
- FLUX.1 [schnell]: Versión open-source bajo licencia Apache 2.0, optimizada para 1-4 pasos de sampling. La más rápida de la familia, ideal para iteración rápida en local.
- FLUX.1 [dev]: Versión mejorada con 10B de parámetros, licencia «no-commercial use», calidad superior a Schnell con hasta 10–25 pasos. Disponible en Hugging Face.
- FLUX.1 [pro]: Versión de producción exclusivamente vía API (Black Forest Labs, Replicate, fal.ai), con el máximo nivel de calidad, sin acceso a pesos.
Familia Stable Diffusion 3.5:
- SD 3.5 Large (8B parámetros): Máxima calidad, requiere 24 GB de VRAM en FP16; en BFloat16 funciona en GPUs de 16 GB con atención flash.
- SD 3.5 Large Turbo: Versión distilada para inferencia en 4 pasos, manteniendo 85–90% de la calidad del modelo base a 5× más velocidad.
- SD 3.5 Medium (2.5B): Formato compacto para GPUs de consumo (8–12 GB VRAM), ideal para integración en aplicaciones móviles y edge computing.
6. Tabla Comparativa: FLUX.1 Pro vs. SD 3.5 vs. Midjourney V6.1 vs. DALL-E 3
| Característica | FLUX.1 Pro | SD 3.5 Large | Midjourney V6.1 | DALL-E 3 |
|---|---|---|---|---|
| Arquitectura base | RF-Transformer 12B | MMDiT 8B + T5-XXL | Propietaria (desconocida) | Difusión + ChatGPT |
| Fotorrealismo | ⭐⭐⭐⭐⭐ Líder | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐ |
| Texto en imágenes | ⭐⭐⭐⭐ (70–85%) | ⭐⭐⭐ (65–75%) | ⭐⭐ (40–55%) | ⭐⭐ (45–60%) |
| Open Source / Local | ❌ Solo API | ✅ Pesos libres | ❌ Solo web | ❌ Solo API |
| Precio por imagen | $0.04–$0.06 | Coste de GPU local | $0.04 (suscripción) | $0.04–$0.08 |
| Control fine-grained | Alto (via ControlNet) | Muy Alto (ecosistema SD) | Medio (panning, zoom) | Bajo |
7. Flujos de Trabajo Profesionales: ComfyUI, APIs y Integración en Pipelines Creativos
La mayor ventaja de Stable Diffusion 3.5 frente a FLUX.1 Pro en entornos profesionales es la riqueza de su ecosistema de herramientas. ComfyUI, A1111 y InvokeAI han incorporado soporte nativo para SD 3.5, permitiendo workflows modulares complejos:
- ControlNet para SD 3.5: Control preciso de postura, profundidad, bordes y mapas normales para reproducir composiciones específicas con exactitud.
- IP-Adapter: Transferencia de estilo de imagen de referencia manteniendo el contenido del prompt.
- LoRA y DreamBooth Adaptados: Fine-tuning ligero para estilos artísticos personalizados, personajes específicos o identidades de producto de marca.
FLUX.1 Pro se integra fundamentalmente via API (Replicate, fal.ai, Black Forest Labs direct), con SDKs de Python sencillos que encajan perfectamente en pipelines de generación masiva automatizada. Para un estudio de diseño que necesita generar 10.000 variaciones de packaging en 24 horas, la API de FLUX.1 Pro es la solución más directa. Para un artista digital que necesita control granular de la composición con múltiples controladores, SD 3.5 en ComfyUI es imbatible. También puedes aprender a integrar generación de imágenes en flujos automatizados completos en nuestra guía sobre agentes autónomos de producción.
8. Preguntas Frecuentes sobre Modelos de Difusión de Próxima Generación
¿Qué GPU necesito para ejecutar FLUX.1 Dev o SD 3.5 Large en local?
FLUX.1 Dev requiere un mínimo de 16 GB de VRAM para ejecutarse en precisión BFloat16 (NVIDIA RTX 3090, 4080, 4090 o superiores). SD 3.5 Large tiene requerimientos similares: 24 GB en FP16 o 12–16 GB con cuantización INT8/FP8 usando la librería bitsandbytes. Para usuarios con GPUs de 8 GB, SD 3.5 Medium es la variante recomendada y produce resultados excelentes para el hardware disponible.
¿Puedo usar FLUX.1 o SD 3.5 para proyectos comerciales?
Depende de la variante específica. FLUX.1 [schnell] tiene licencia Apache 2.0 y permite uso comercial libre. FLUX.1 [dev] tiene licencia no comercial. FLUX.1 [pro] mediante API es comercialmente utilizable con acuerdo de servicio. SD 3.5 Large usa la Stability AI Community License que permite uso comercial gratuito para empresas con ingresos inferiores a 1 millón de dólares anuales; por encima de ese umbral requiere licencia comercial.
¿Qué es ControlNet y cómo mejora la precisión compositiva en SD 3.5?
ControlNet es una arquitectura adaptadora que añade condicionamiento adicional al modelo de difusión mediante mapas de control estructural: detección de bordes (Canny), estimación de profundidad (MiDaS), pose humana (OpenPose) o mapas normales de superficie. Con ControlNet, puedes proporcionar una silueta, un esqueleto de pose o una imagen de referencia de perspectiva y el modelo generará imágenes que respetan esas restricciones estructurales mientras aplica el estilo y contenido del prompt de texto.
¿Cuántos pasos de sampling son óptimos para equilibrar calidad y velocidad?
Para FLUX.1 Schnell (distilado): 4 pasos son suficientes y óptimos. Para FLUX.1 Dev: 25–30 pasos ofrecen el mejor equilibrio calidad/velocidad. Para SD 3.5 Large: entre 28 y 40 pasos con scheduler DPM++ 2M Karras producen resultados óptimos. Superar los 50 pasos raramente aporta mejora visual perceptible y solo incrementa el tiempo de generación. El scheduler elegido (DDIM, DPM++, Euler) tiene tanto impacto en el resultado final como el número de pasos.